

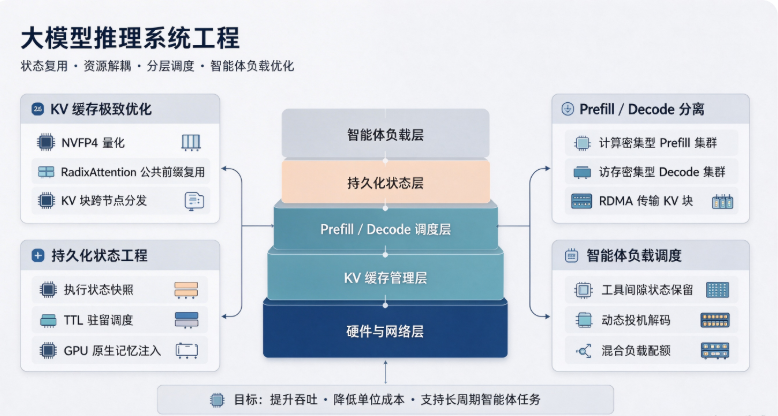
当前大模型的能力瓶颈,早已不在模型架构本身,而在推理系统工程。2026 年 Q3 至 Q4 的行业进展,集中在四个可落地、可量化的技术方向:KV 缓存的极致压缩与跨会话共享、Prefill/Decode 阶段分离与异构调度、持久化状态与增量推理、面向智能体负载的专项调度优化。所有方向均已进入生产级验证阶段,而非概念性探索。
一、KV 缓存:从单会话存储到全局共享与极致量化
KV 缓存是长上下文与智能体场景下最大的显存消耗项,也是当前优化最密集的领域。2026 年的进展已经突破“单会话内压缩”的范畴,进入全局共享、多级量化、跨节点分发的阶段。
1. FP4 量化进入生产可用,显存占用再减半
FP8 KV 缓存已成为行业标配,而 2026 年的核心推进是 4 位量化的落地。NVIDIA 随 Blackwell 架构推出的 NVFP4 格式,是当前落地最广的方案:它采用两级缩放机制,每 16 个值共享一个 FP8 块级缩放因子,整个张量再共享一个 FP32 全局缩放因子,相比单全局缩放的方案,局部动态范围控制更精细,量化误差被控制在推理可接受范围内。
实测数据显示,同上下文长度下,NVFP4 KV 缓存的显存占用约为 FP16 的 1/4、FP8 的 1/2。在 70B 级模型 128K 上下文场景中,单会话 KV 缓存从约 16GB 压缩至 4GB 以内,解码阶段的显存带宽需求同步降低 50% 以上。DeepSeek V4.1 Flash 进一步将单 Token 缓存压缩到 890 字节,结合跨层 KV 复用与滑动窗口注意力,在端侧设备上即可支撑长上下文推理。
2. 跨会话前缀共享:从重复计算到全局复用
传统推理中,不同会话的系统提示、公共前缀、工具定义等内容会被重复计算 Prefill,冗余度极高。2026 年成熟的方案是基于前缀树(Radix Tree)的全局 KV 共享。
SGLang 2.0 提出的 RadixAttention v2,将所有会话的 KV 块以 Radix 树结构组织在全局内存中。新请求到达时,调度器自动匹配最长公共前缀,已计算过的 KV 张量 100% 复用,对应部分完全跳过 Prefill 计算。实测显示,对于存在大量公共前缀的智能体与客服场景,Prefill 计算量可降低 85%,首 Token 延迟(TTFT)可控制在 25ms 以内。
NVIDIA Dynamo 架构中的 KV Block Manager(KVBM)走得更远:KV 块计算一次后,通过写通机制从 GPU 流向 CPU 内存再到磁盘存储,全局按序列哈希去重。当子智能体在不同工作节点启动时,通过 NIXL(RDMA 读取)直接加载公共前缀的 KV 块,无需重新计算。原本 4 次冗余的 Prefill 变为 1 次计算 + 3 次读取,智能体子任务冷启动延迟降低一个数量级。
3. 多级缓存与跨节点分发
面对 TB 级的历史 KV 数据,单 GPU 显存无法承载,行业普遍转向四级存储架构:热数据驻留 GPU 显存,温数据迁移至 CPU 内存,冷数据落盘,跨节点通过类似 CDN 的架构分发。
中兴通讯提出的 KVCDN 架构,将 KV 缓存按地理与领域属性分级部署:边缘节点缓存垂直领域热点前缀,核心节点构建全局前缀字典树,通过特征匹配实现跨区域物理去重。这套架构将广域网内的 KV 缓存命中率提升了 40% 以上,特别适合多区域部署的大规模推理集群。
二、Prefill 与 Decode 分离:推理阶段的资源解耦
Prefill(预填充)与 Decode(解码生成)是两个计算特性完全不同的阶段:Prefill 是计算密集型,大量矩阵乘法,高算力利用率;Decode 是访存密集型,每步只生成一个 Token,瓶颈在显存带宽。传统架构将两个阶段混部在同一 GPU 上,导致资源利用率始终无法打满,且两类任务互相干扰。
2026 年,Prefill/Decode 分离部署从可选优化变成大规模集群的标准架构。
1. 分离架构的核心逻辑
分离部署的本质是资源解耦:
- Prefill 集群:配置高算力密度 GPU,负责批量处理输入提示、计算 KV 缓存、输出结构化 KV 块。可以独立扩缩容,应对输入流量波动。
- Decode 集群:配置高显存带宽 GPU,负责接收 KV 块、逐 Token 生成、增量更新缓存。专注于吞吐与生成延迟优化。
- 传输层:通过统一的 KV 块格式与高速网络(RDMA/InfiniBand)完成跨节点 KV 传输。
DeepSeek 开源的 DeepInfer 框架即采用该架构:线上部署中 8 卡服务器承担 Prefill 输入处理,64~128 卡超节点负责 Decode 逐 Token 生成,两个阶段独立配置资源。基于该框架的生产集群日吞吐达到 155 万亿 Tokens,按当前电价测算单卡每小时产出约 254 元人民币。
2. 落地的关键难点
分离架构的核心挑战是 KV 块的格式对齐。以 Qwen3.8 模型为例,其 GDN 状态与 Full-Attention 状态的单块显存占用相差 2108 倍,Prefill 与 Decode 两端的块大小必须严格匹配才能直接传输,否则会产生空间浪费或传输失败。vLLM 的 PD Serving 模式中,块大小需要按 GDN 状态对齐,两端独立计算后统一校验,这也是分离部署的标准工程实践。
三、持久化推理:从请求式到状态常驻的工程实现
智能体场景下,传统“请求-响应”式推理的痛点集中暴露:多轮任务频繁冷启动、工具调用后上下文重建、子任务分叉重复计算。2026 年的持久化推理技术,已经从概念走向可工程化的状态管理方案。
1. 执行状态快照:不止是 KV 缓存
持久化的核心是完整推理状态的可保存、可恢复、可分叉。传统方案只保存 KV 缓存,但实际推理状态还包括算子中间结果、位置编码状态、调度上下文等,单独恢复 KV 会导致状态不一致。
2026 年提出的 Execution-State Capsule(执行状态胶囊)技术,基于静态连续缓冲区与图绑定执行模型,将完整的执行状态冻结在一组命名缓冲区中。状态快照不仅包含 KV,还包含所有计算图依赖的中间张量。实测显示,在相同硬件与模型下,其状态恢复的首 Token 延迟比 vLLM 低 2.6~2.8 倍,并且支持会话分叉(fork)、回滚(rollback)与重入,天然适配智能体的分支任务场景。
2. 驻留调度:基于 TTL 的缓存生命周期管理
持久化不意味着所有会话常驻显存,那样会导致显存耗尽。工程上的方案是基于“存活时间(Time-to-Live, TTL)”的选择性驻留。
加州大学伯克利分校提出的 Continuum 调度系统,针对智能体多轮任务,为每个会话的 KV 缓存计算 TTL 值:综合考虑重新加载的计算成本、驱逐后的排队延迟、当前显存压力,决定是否将缓存钉在 GPU 中。TTL 到期后自动降级到 CPU 内存或淘汰。实测在 SWE-Bench 等真实智能体基准上,平均任务完成时间提升 8 倍,同时保持高吞吐率。
3. 记忆的原生注入
对于带有长期记忆的智能体,传统方案是将记忆文本检索后拼入提示词,每次都要重新 Prefill。InferScale 系统提出了 GPU 原生记忆注入:将每个记忆事实预先计算成 KV 表示,伴随语义向量存储在 GPU 中。检索时直接将对应 KV 块注入推理引擎的分页缓存,跳过文本重新编码。
为解决独立编码的位置编码问题,该方案引入 Chunked RoPE:存储旋转前的原始 Key,注入时再应用对应位置的旋转。同时通过上下文窗口编码缓解跨记忆事实的上下文缺失问题。整套机制无需修改推理引擎,通过 vLLM 的 KV-connector 接口即可实现。
四、面向智能体负载的调度优化
智能体推理和传统问答推理的负载特征完全不同:存在大量工具调用中断、子任务分叉、短请求高频触发、上下文碎片化。传统针对均匀长对话的调度策略在智能体场景下效率极低。2026 年出现了一批针对性的调度优化。
1. 工具调用间隙的资源复用
智能体调用工具时,推理进程挂起,GPU 处于空闲状态。传统调度会直接释放显存,等工具返回后重新加载,导致大量冷启动开销。
Continuum 等系统的做法是:在工具调用期间,不立即驱逐 KV 缓存,而是保留一个短 TTL 窗口。如果工具在窗口内返回,直接继续推理,零额外开销。TTL 时长根据工具调用的统计分布动态调整,既保证大多数命中,又避免显存长期占用。
2. 投机解码的工程化落地
投机解码(Speculative Decoding)是提升解码吞吐的成熟技术,但在智能体场景下,输出长度不确定、频繁中断,导致投机命中率下降。
2026 年的工程优化集中在两方面:一是草稿模型的动态深度调整,根据输出置信度自适应预测 Token 数,DeepInfer 的实现可带来约 6% 的吞吐提升;二是将投机解码与 Prefill/Decode 分离架构结合,草稿计算放在 Prefill 端空闲算力上执行,不占用解码端的带宽资源。
3. 混合负载调度
生产集群往往同时承载普通 API 请求与持久化智能体任务。2026 年的标准做法是“混合调度 + 资源配额”:为持久会话预留固定的显存配额,剩余显存用于弹性的无状态请求;空闲周期利用 GPU 余量预计算热点前缀,推高整体利用率。
典型部署中,单张 80GB Blackwell GPU 可同时承载 2030 路活跃持久智能体会话,外加数百路并发的普通问答请求,整体算力利用率从传统的 30%40% 提升到 65% 以上。
大模型推理的竞争,已经全面从“模型算法”转向“系统工程”。
上述四个方向的共同逻辑是一致的:不再追求单次推理的极致速度,而是通过状态复用、资源解耦、分层调度,提升整个系统的吞吐、降低单位成本、适配更复杂的智能体负载。模型本身的能力差距正在缩小,推理系统的工程能力,正在成为大规模部署与商业化落地的核心竞争力。
接下来的演进方向也很明确:KV 缓存的全局共享率会继续提升,状态迁移的成本会继续降低,智能体负载的调度会更精细。而所有这些优化,最终都会指向同一个目标——让高并发、长周期、多分支的智能体系统,能够以可接受的成本稳定运行。
